已檢索 - 目前尚未建立索引:狀態定義與排查順序
TL;DR
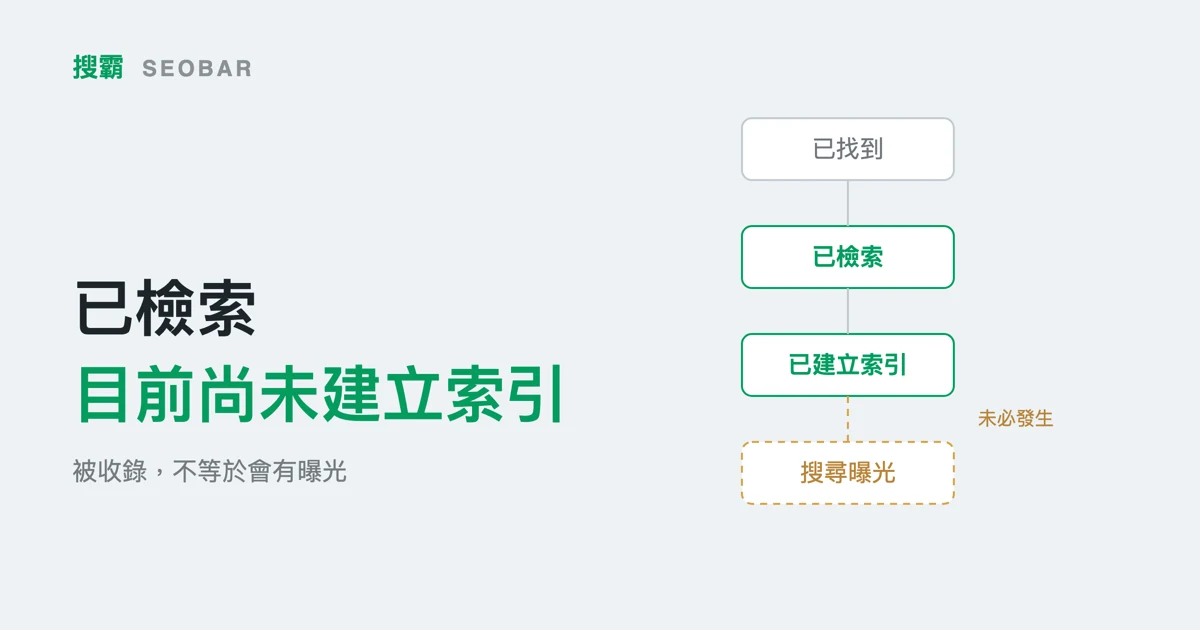
- 「已檢索 - 目前尚未建立索引」在 Google 文件裡不是錯誤,官方明寫「不必將這個網址重新送交檢索」
- 它與「已找到 - 目前尚未建立索引」的差別在於 Google 有沒有真的讀過內容,兩者的處理方向不同
- 被建立索引只是入場券,索引狀態正常但完全沒有曝光是可能的,而且不會出現在任何錯誤清單裡
- 真正該先排除的是 robots.txt、canonical 與回應碼三項設定,其餘多數情況不是技術問題
- 排除設定之後仍然沒有動靜,通常是選了一個現階段競爭過強的查詢,換題目比反覆調整這一頁有效
- 零曝光是 Google 排名階段的判斷,AI 搜尋的檢索方式不同,同一頁在兩邊的處境未必一致
目錄
已檢索 目前尚未建立索引的官方定義
已找到與已檢索兩種狀態的差別
索引狀態與搜尋曝光的區分
已編入索引卻沒有曝光的實際案例
AI 搜尋的檢索方式與排名篩選的差異
零曝光頁面在 AI 搜尋中的處境
常被誤認為原因的三個設定
這個狀態的處理順序
引言
打開 Search Console 的網頁索引報告,看到一批網址被歸在「已檢索 - 目前尚未建立索引」,多數人的第一個反應是把它當成故障:重新送交、改標題、加內部連結、再送交一次。
中文圈的教學文章大致也是這樣寫的。但 Google 自己的文件對這個狀態的說法完全不同,而且明確到不太有解釋空間。
已檢索 目前尚未建立索引的官方定義
Google 對這個狀態的定義是「Google 已檢索網頁,但尚未建立索引。日後可能會建立索引」,建議的處理方式只有一句:「不必將這個網址重新送交檢索。」(網頁索引報告說明)
網頁索引報告把狀態分成「錯誤」「有效但有警告」「有效」「已排除」幾類,而這個狀態不在錯誤那一類。它描述的是一個進行中的狀態,不是一個失敗的結果。
反覆送交沒有效果的原因也在這裡:Google 不是漏看了這個網址,是看過之後決定先不收。再送一次不會改變判斷所依據的條件。
已找到與已檢索兩種狀態的差別
同一份報告裡還有一個很像的狀態,「已找到 - 目前尚未建立索引」。兩者差一個字,指的卻是流程上完全不同的位置。
| 狀態 | Google 走到哪一步 | 官方說明的重點 |
|---|---|---|
| 已找到 - 目前尚未建立索引 | 知道網址存在,還沒讀內容 | 想檢索,但預期會造成該網站流量超載 |
| 已檢索 - 目前尚未建立索引 | 已經讀過內容,決定先不收 | 日後可能會建立索引,不必重新送交 |
「已找到」是抓取端的排程問題,Google 文件把原因歸在伺服器負載的預期上。這一類會受主機回應速度影響,也跟網站的整體規模有關。
「已檢索」則是內容評估之後的結果。Google 讀過了,只是還沒決定把它放進索引。這兩種狀態如果用同一套方法處理,方向會反過來——前者該看的是伺服器與抓取預算,後者該看的是這一頁本身值不值得被收。
索引狀態與搜尋曝光的區分
多數討論停在「有沒有被收錄」,把它當成終點。實際上它是入場券,而不是結果。
一個網址進到索引之後,還要在某個查詢的候選集合裡被排到前面,才會產生曝光。索引與曝光之間隔著整個排序階段,那一段跟索引狀態沒有直接關係。
有一種狀況在報告上一切正常,在現實中卻沒有任何動靜:網頁索引報告顯示「網頁已編入索引」,成效報告的曝光是零。這種情況不會出現在錯誤清單裡,因為它在技術上並沒有錯。
已編入索引卻沒有曝光的實際案例
本站於 2026 年 8 月底上線,零外部連結。八篇文章中有七篇在發佈當天就取得第一次曝光——「新網站要等好幾週才會被收錄」這個說法,至少在這個案例上不成立。
剩下那一篇是有意思的一個。發佈兩週後仍然沒有任何曝光,用網址審查工具查它,結果是「網頁已編入索引」。
它不在「已檢索 - 目前尚未建立索引」裡,也不在任何錯誤或排除清單裡。Google 讀了、收了、放進索引,然後它在每一個相關查詢上都沒有排進使用者會看到的範圍。
差別在題目。那一篇打的是「Google Search Console 設定教學」這類頭部關鍵字,同樣的主題已經有官方說明文件、大型內容站與經營多年的部落格佔住前排。同一批文章裡表現最好的兩篇,主題分別是 canonical 的判斷邏輯與 HTTP 狀態碼的差異——查詢更精確、競爭者更少。
技術設定完全相同,結果差這麼多。這個對照指向的判斷很直接:排不上去不一定是頁面有問題,也可能是選了一場現階段打不贏的仗。
AI 搜尋的檢索方式與排名篩選的差異
前面談的零曝光,是 Google 排名階段的結果:一個查詢只有十個位置,排不進去就沒有曝光。這條規則對 AI 搜尋並不直接適用,因為它取用內容的方式不一樣。
差別有三個層次。
查詢會被拆開。 使用者問一個完整的問題,系統不會拿原句去比對,而是拆成數個更窄的子查詢分別檢索,再把結果合起來回答(Google 對 AI 模式的說明稱之為 query fan-out,直譯是「查詢扇出」)。一個在頭部關鍵字上排不進前幾頁的頁面,仍可能因為回答得了其中一個子問題而被取用。
取用的單位是段落,不是整頁。 生成答案時模型引用的是頁面裡的某一段,不是整個頁面的綜合評分。一篇整體競爭力不足、但其中一段把某個具體問題講得完整的文章,在這個機制下不是沒有機會。
候選集合小得多。 十個藍色連結是給人挑的,AI 生成答案時通常只採用少數幾個來源。位置的意義因此改變:排名第八在藍色連結的世界裡幾乎沒有點擊,在 AI 引用的世界裡則未必落選。
需要同時說明的是,這不代表索引無關緊要。Google 的 AI 摘要與 AI 模式建立在同一套索引上,沒有進索引就不在候選範圍內;多數 AI 助理的檢索也仍建立在既有搜尋索引之上。索引是門票,改變的是門票之後那道篩選的形狀。
零曝光頁面在 AI 搜尋中的處境
兩邊的差異不只是理論。本站的 AI 爬蟲分析對同一批頁面比對過兩種爬蟲的抓取偏好:純 AI 爬蟲與傳統搜尋引擎爬蟲的抓取分布,相關係數是 -0.01,接近完全無關。搜尋引擎最常抓的頁面,跟 AI 系統最常抓的頁面,是兩份幾乎不重疊的名單。另一份 30 天的爬蟲紀錄顯示,AI 爬蟲反覆讀的甚至不是文章,而是 sitemap.xml,三個網站的 sitemap 爬取有近八成來自 AI(見 AI 爬蟲實測:sitemap.xml 的爬取有近八成來自 AI 而非搜尋引擎)。
這與一份 GEO 引用失敗的分析結果方向一致。該研究把引用失敗的原因拆解後,62.2% 來自語意對齊問題(意圖分歧、缺少實體術語、在地化不符),只有 10.1% 屬於技術問題;同時有 43% 的主題相關頁面在 AI 引擎上零引用(Diagnosing and Repairing Citation Failures in Generative Engine Optimization,arXiv 預印本,單一來源,方向可參考但不宜當定律)。
把這些放回「已編入索引但零曝光」的處境:那一頁在 Google 的排名階段落選,但落選的理由是競爭者太強,不是內容不能回答問題。如果它把某個具體問題講得夠完整、術語與使用者的問法對得上,它在 AI 搜尋的檢索裡仍有被取用的空間。
這條路徑有兩個限制。
AI 搜尋有它自己的門檻。 本站在上線第五天實測時,ChatGPT 直接拒絕開啟這個網域,回的是抓取端的錯誤而不是內容評估——新網域在 AI 這一側同樣要先過一道准入(新網域上線第 5 天,ChatGPT 拒絕開啟)。
被引用不等於有流量。 AI 把答案直接寫在使用者面前,來源連結的點擊率遠低於藍色連結。在成效報告上,這會呈現為排名不錯但點擊接近零——那不一定是標題寫得不好,可能是答案已經在上面被讀完了。
比較實際的作法是分開看:Google 這一側處理排名與選題,AI 這一側處理「這一段有沒有把一個具體問題講完整、用的是不是使用者會用的詞」。兩件事的優化方向不同,用同一套指標衡量會得到互相矛盾的結論。
常被誤認為原因的三個設定
在把時間花在內容之前,還是有三項設定值得先排除。它們確實會擋住索引,只是遠不如一般認為的那麼常見。
robots.txt 的 disallow 擋的是抓取,不是索引。被擋住的網址仍可能因為外部連結而以「已建立索引,但遭 robots.txt 封鎖」的狀態出現。要讓一個網址不進索引,正確的工具是 noindex,而 noindex 必須讓 Google 讀得到頁面才會生效——同時使用 disallow 與 noindex,後者不會被讀到。(robots.txt 的寫法與常見錯誤)
canonical 指向別的網址。當一頁的 canonical 指向另一個網址時,Google 通常會把索引集中在被指向的那一個,這一頁就會顯示為「重複網頁;Google 選擇的標準網頁和使用者指定的不同」。這在自動產生 canonical 的模板上特別容易發生。(canonical 的判斷與常見設錯)
回應碼與內容不一致。頁面回 200 但實際顯示錯誤訊息或空白,會被判定為 soft 404 而排除在索引之外。這一類最難自己發現,因為瀏覽器看起來一切正常。(HTTP 狀態碼與 SEO)
三項都排除之後仍然停在未索引,剩下的就不是設定問題了。
這個狀態的處理順序
先確認是哪一種狀態。「已找到」看伺服器回應時間與網站規模,「已檢索」看這一頁的內容與它在站內的位置。兩者用錯方法都不會有進展。
接著用網址審查工具直接看 Google 抓到的是什麼,比推測快得多。三項設定逐一排除:robots.txt 有沒有擋住這條路徑、canonical 是不是指向別的網址、回應碼與實際內容有沒有對上。這三項確認完,多數「以為是技術問題」的情況就結束了。
再來是內容本身。Google 讀過之後決定先不收,通常指向幾種情況:這一頁與站內其他頁高度重疊、內容單薄到沒有獨立存在的理由、或者整個網站還沒有累積足以支撐這麼多頁面的信任。前兩種可以靠合併或改寫處理,第三種需要時間與其他頁面的表現一起累積。
最後是一個不在任何檢查清單上、影響卻更大的判斷:這一頁想排的查詢,現在前十名是誰。如果是官方文件與經營多年的大站,那麼「索引狀態正常、曝光是零」會是相當長一段時間內的常態,反覆修改這一頁不會改變結果。
這種情況下比較有效的做法是換一個更精確的查詢重寫,或另外寫一篇打得贏的題目,先讓網站在某幾個查詢上站住。等站台整體有了表現,原本排不上的那些頁面才有機會跟著被重新評估。
需要提醒的是,上述觀察來自單一網站、上線兩週的短期樣本,用來說明判斷方向可以,不足以當成通則。
常見問題
「已檢索 - 目前尚未建立索引」需要重新送交檢索嗎?
不需要。Google 的網頁索引報告說明對這個狀態的建議是「不必將這個網址重新送交檢索」。它不屬於錯誤類別,描述的是 Google 已經讀過內容、但尚未決定收進索引的中間狀態。反覆送交不會改變判斷所依據的條件。
「已找到」和「已檢索」差在哪裡?
差在 Google 有沒有真的讀過內容。「已找到 - 目前尚未建立索引」表示 Google 知道網址存在但還沒抓取,官方說明把原因指向預期會造成網站流量超載,屬於抓取排程問題。「已檢索 - 目前尚未建立索引」則是已經讀過內容之後尚未收錄,要看的是這一頁本身。兩者的處理方向相反。
網頁索引報告顯示「網頁已編入索引」,為什麼搜尋不到?
索引與曝光是兩件事。進入索引只代表這一頁有資格成為候選,還要在某個查詢上被排到使用者看得到的位置才會產生曝光。索引狀態正常但曝光為零不會出現在任何錯誤清單裡,因為它在技術上並沒有錯,常見原因是該查詢的競爭者過強。
用 robots.txt 擋住網址可以避免被建立索引嗎?
不行。robots.txt 的 disallow 擋的是抓取,被擋住的網址仍可能因為外部連結而以「已建立索引,但遭 robots.txt 封鎖」的狀態出現。要讓網址不進索引應該用 noindex,而 noindex 必須讓 Google 讀得到頁面才會生效——同時使用兩者會讓 noindex 讀不到。
網站一直搜不到,想知道卡在哪一關?
抓取、索引、排名、AI 引用是四道不同的關卡,卡在哪一關決定要做什麼。把網址給我,我用實際量測看一遍再跟你說。
技術 SEO 分類其他文章
繼續閱讀同主題的延伸內容
留言討論
只有會員能留言(防止垃圾訊息),留言顯示於此頁。